从文件夹到曲库:音乐文件标签最佳实践
个人曲库系统 · 整理第 1 篇 · 共 4 篇目录
- 01从文件夹到曲库:音乐文件标签最佳实践正在读
- 04入库自动化:一首歌进曲库要过的几道闸2026-10-25
- 05流派树是怎么长出来的待发布
- 06给五千首歌补标签待发布
音乐文件多了以后,最先失效的是文件夹。一首歌既是日语、又是 City Pop、还很适合开车,却只能放进一个目录。我以前的曲库里有「韩」「戏腔」「泡沫经济」「专注」这些文件夹,语言、风格、年代印象和收听场景全混在同一层。
现在的分工是:
- 文件夹只管存放:保留一套专辑结构,不再按语种、曲风、场景分目录
- 标签负责组织:同一份文件,可以从专辑、语言、风格、来源多个入口找到
- 歌单接住主观的分类:「专注」「夜晚」这类几个字段概括不了的选择
- 身份字段先写对:歌、专辑、艺人各管各的
- 分类拆成三个字段:
GENRE管风格,LANGUAGE管语言,GROUPING管作品来源 - 写子流派时,把上级一起写上
- 封面按专辑取,歌词按曲目取
- 响度放在最后算
- 完成的标准,是播放器读到了什么
以 Navidrome + FLAC 为例,规则核对到 2026 年 10 月。流派树和语种归并是按我的收听习惯定的,不是通用的音乐分类标准。1
先拆开一首歌
以山下达郎的《SPARKLE》为例,它在磁盘上的位置是:
17 山下达郎/【1982】FOR YOU/01. 山下达郎 - SPARKLE.flac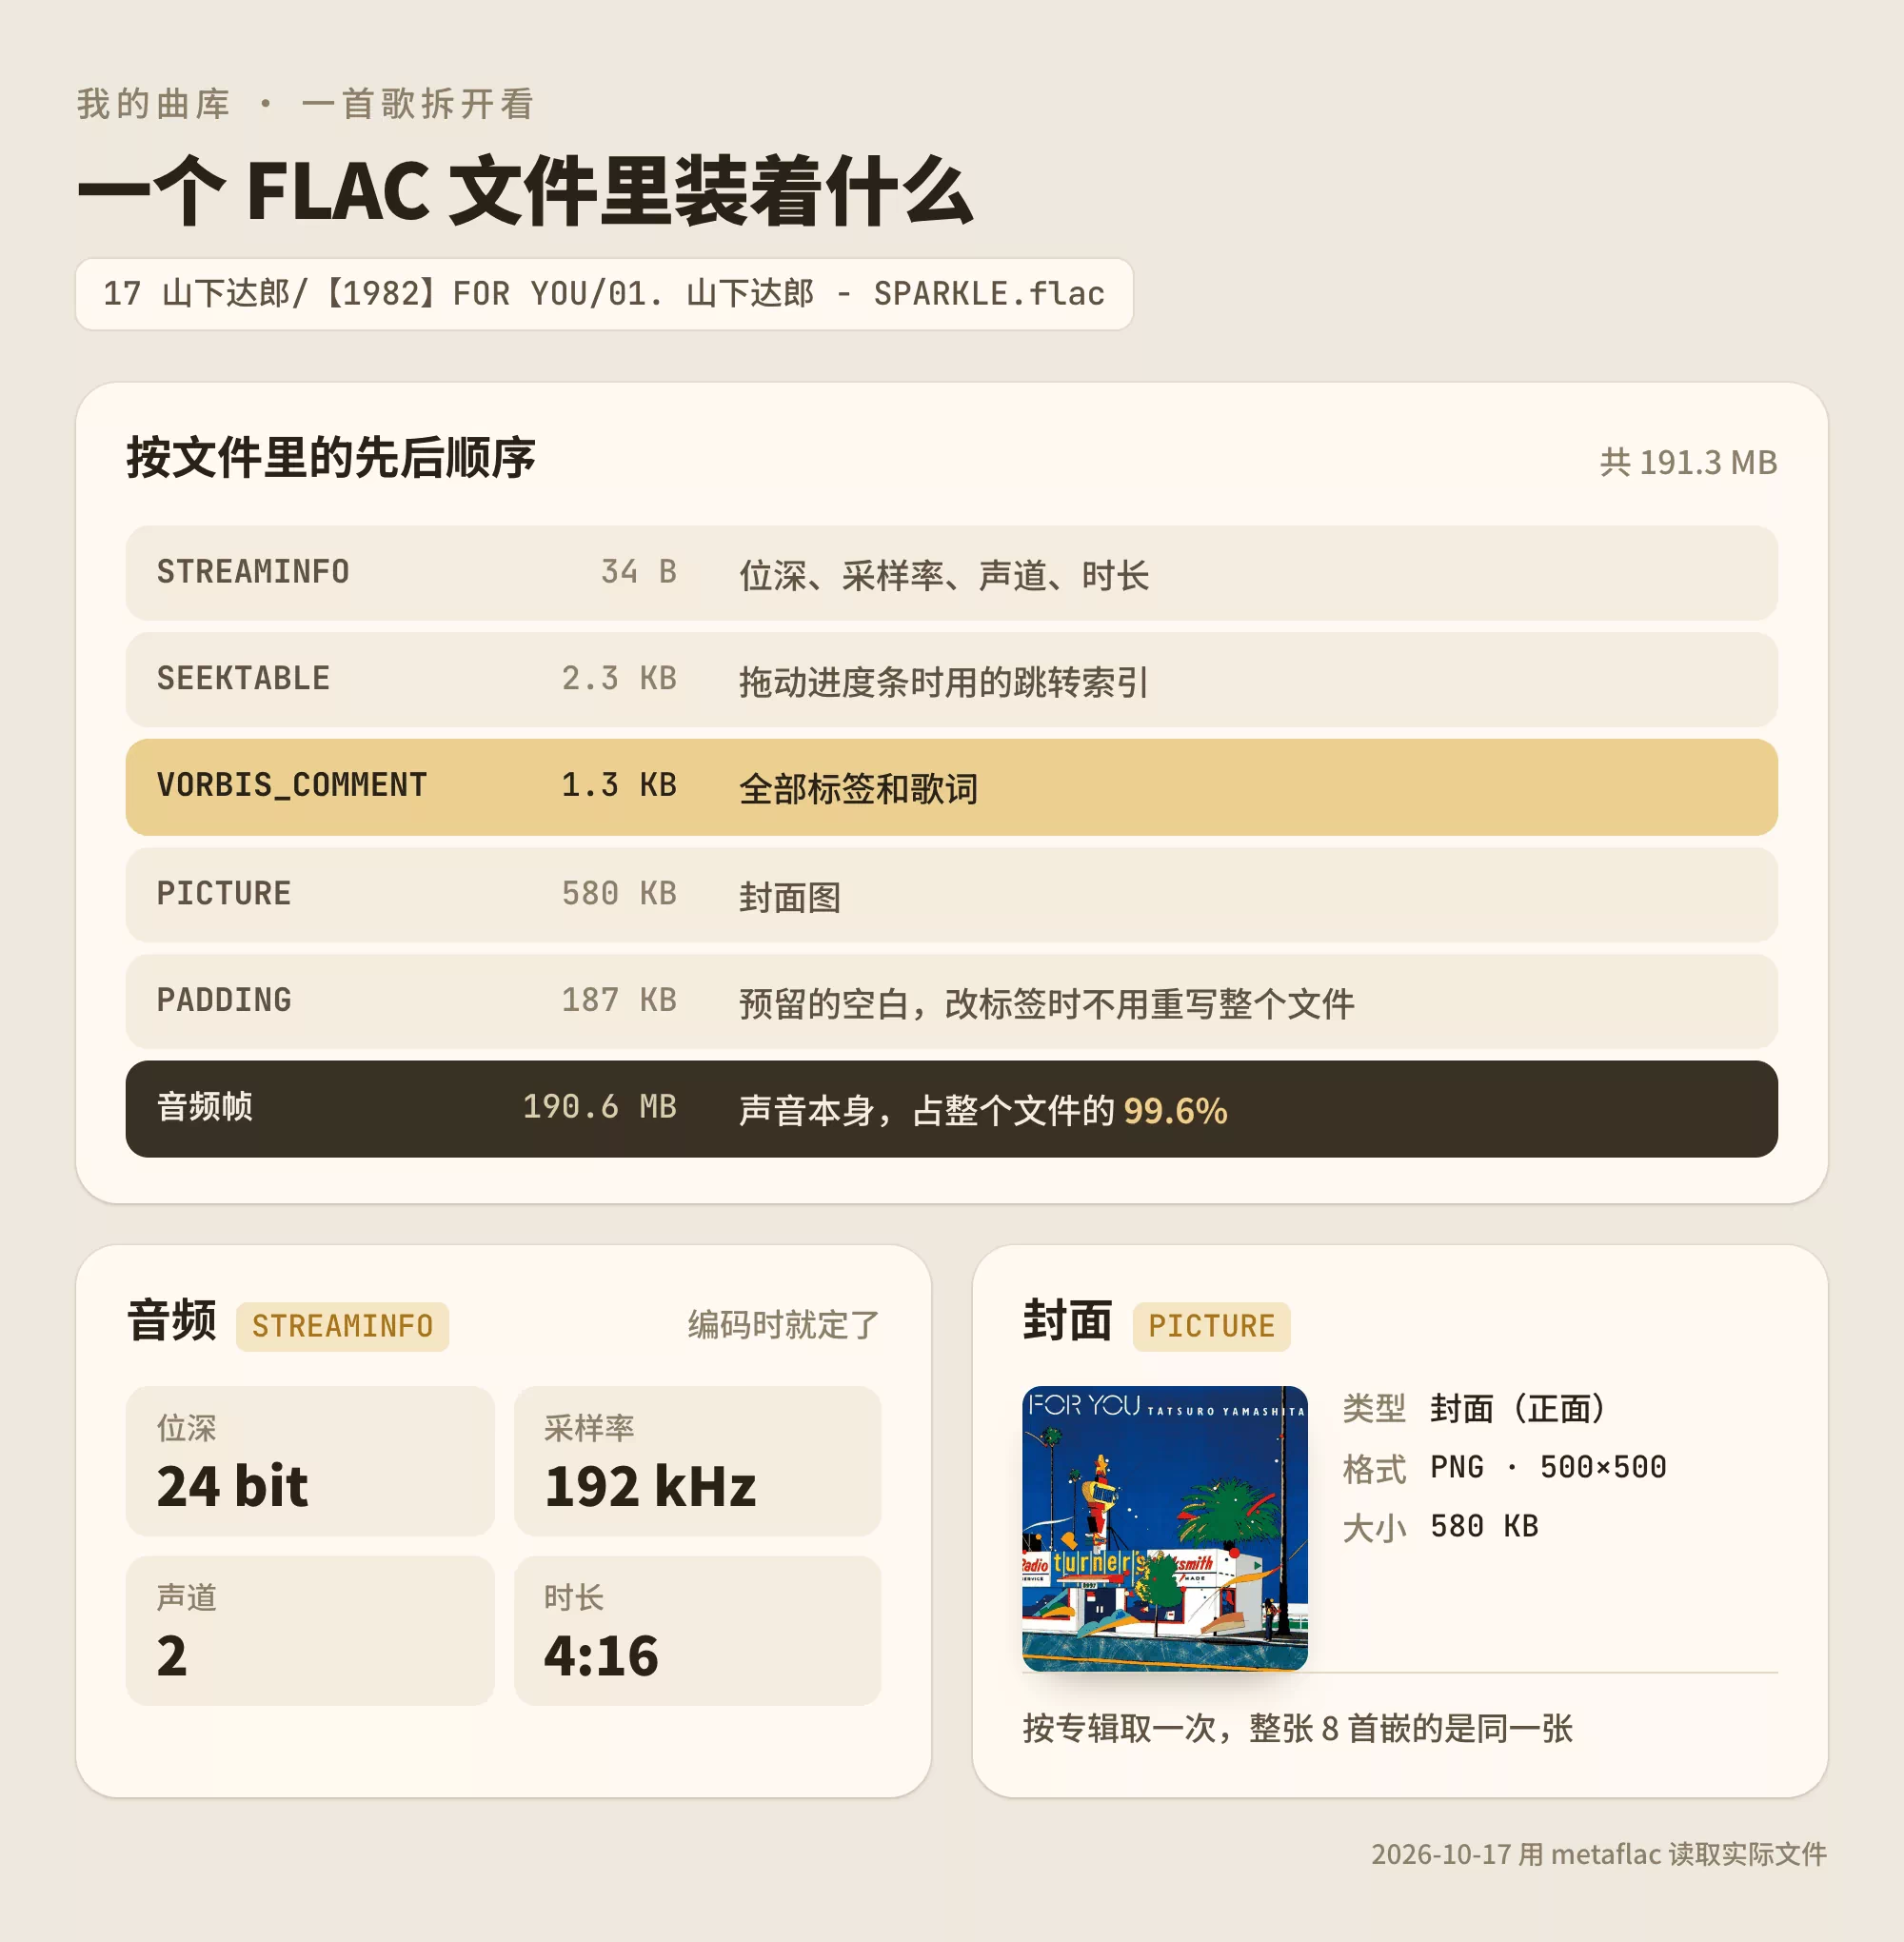
图中各块大小与音频参数来自这份文件的实际回读。
一个 FLAC 文件里有三层东西:2
- 音频:保存声音。采样率、位深是技术参数,和自己填的分类无关
- 标签(Vorbis Comment):说明它是谁、该怎样归类;歌词和响度增益也是其中的字段
- 封面:单独存在 PICTURE 块里,按专辑统一
播放器显示的歌名、艺人、流派都来自文件内部。文件名只是给人看的入口,不必承担全部信息。
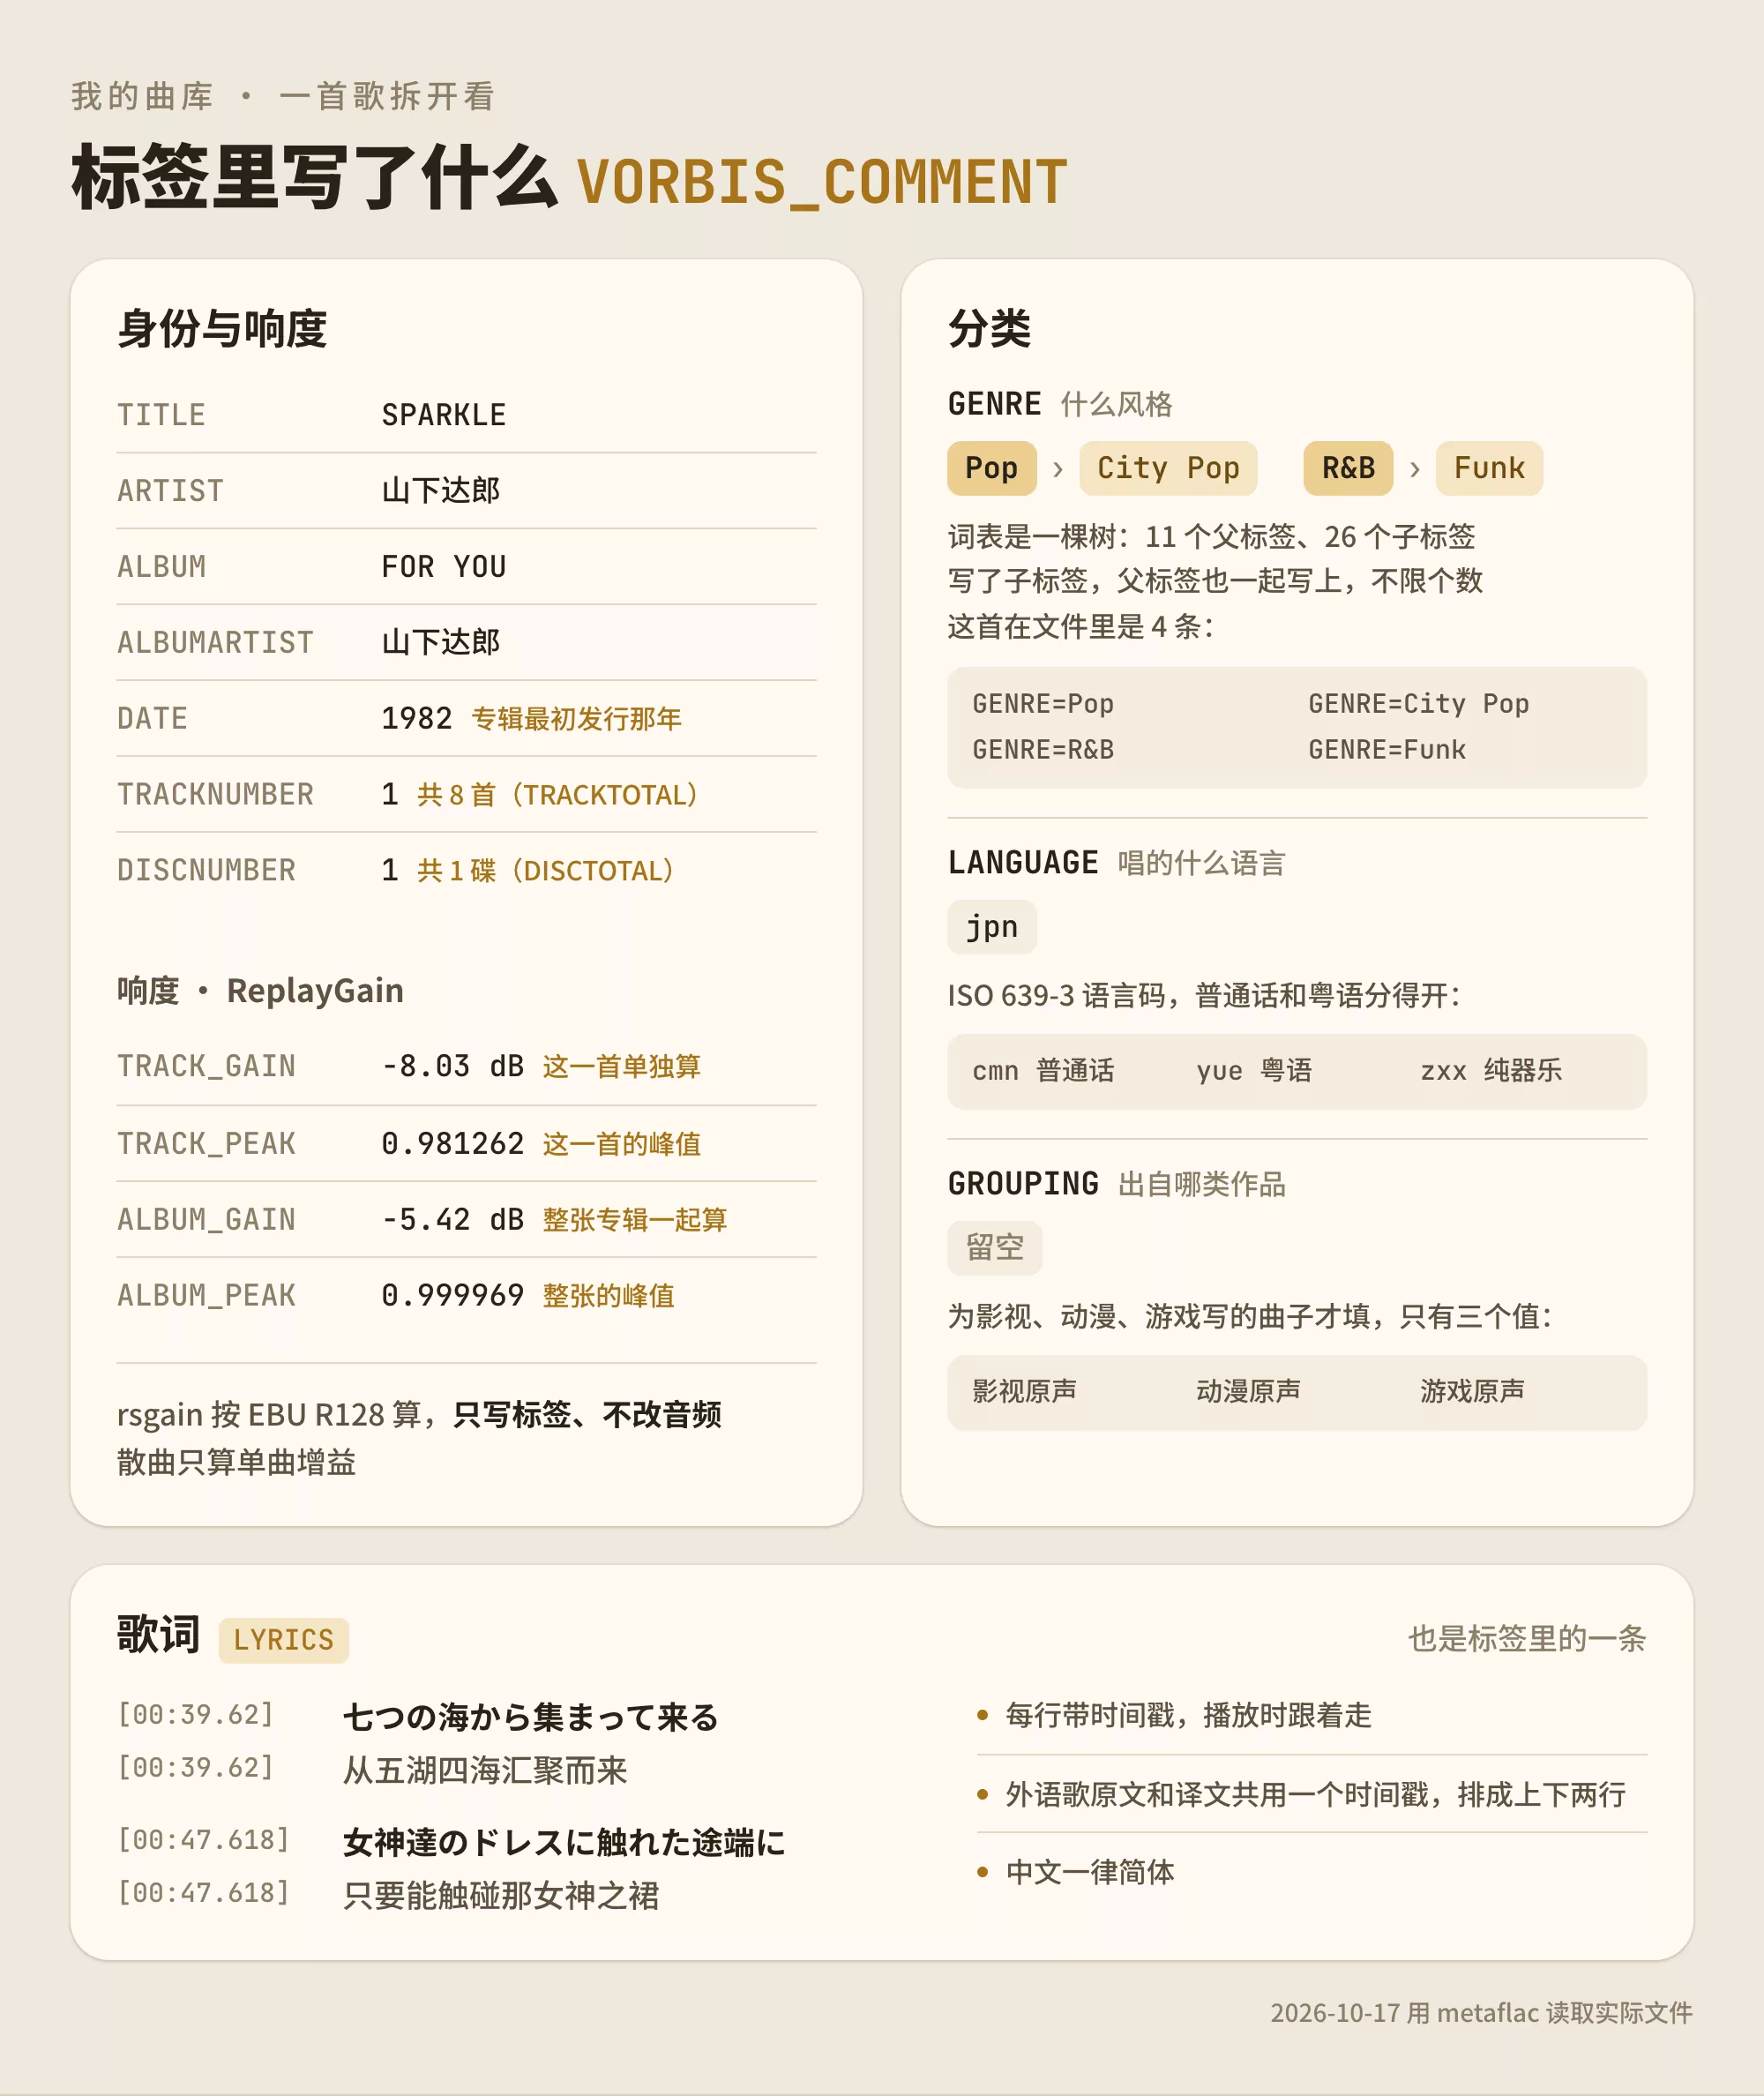
标签、响度值与歌词同样来自实际回读。
文件夹:只留一套结构
目录按发行来分:
- 成套的原声带进原声带目录
- 完整专辑按艺人归档,或者放进「其他专辑」
- 散曲进「精选单曲」的批次目录
看是不是一次完整发行,不看曲目数。五首歌的爵士唱片、六首歌的 EP,都是完整的收听单位。
新文件的命名尽量简单:
专辑:01. 艺人 - 曲名.flac
散曲:艺人 - 曲名.flac
以前藏在文件夹里的分类,现在各有去处:
| 以前的文件夹 | 现在交给 |
|---|---|
| 韩 | 语种筛选(LANGUAGE=kor) |
| 戏腔 | 流派筛选(GENRE=戏腔) |
| 专注 | 手选歌单3 |
一份文件可以出现在很多集合里,不用复制。以后想换一种听法,改筛选条件或歌单就行,不必搬家。
身份字段:歌、专辑、艺人各管什么
分类再精细,认错了录音也没有意义。录音室版、现场版、重制版、伴奏版,不能因为歌名一样就共用元数据。匹配时同时核对艺人、专辑、版本、时长。
| 字段 | 回答的问题 | 我的写法 |
|---|---|---|
TITLE |
这首曲目叫什么? | 实际曲名,保留必要的版本区别 |
ARTIST |
这一首由谁演绎? | 按曲目写,客串艺人照实保留 |
ALBUM |
收录在哪张发行里? | 同一张专辑统一名称,散曲也保留来源专辑 |
ALBUMARTIST |
这张专辑署在谁名下? | 按专辑署名,整张统一 |
DATE |
这张专辑最初哪年发行? | 只写四位年份 |
TRACKNUMBER / TRACKTOTAL |
本碟第几首、共几首? | 按每碟填写 |
DISCNUMBER / DISCTOTAL |
第几碟、共几碟? | 单碟专辑也写 1 / 1 |
最容易写错的有三处:
ARTIST和ALBUMARTIST不是一回事- Eminem 的专辑客串很多,每首的
ARTIST可以不同,ALBUMARTIST仍然是 Eminem,不能因为参与者多就写成「群星」 - 原声带有署名主创就写主创;没有统一主人的多艺人合辑,才写
V.A. - 两位独立艺人联名的专辑写两个值;固定组合名保留整体,不把几个人拼成新名字
- Eminem 的专辑客串很多,每首的
- 音轨总数按碟计算
- 双碟专辑,第一碟 20 首、第二碟 9 首:第二碟最后一首是「第 9 首 / 共 9 首,第 2 碟 / 共 2 碟」,不是「第 9 首 / 共 29 首」4
DATE记专辑的首发年- 再版沿用原专辑的年份,合辑用合辑自己的出版年,不逐首换成歌曲首发年
- 代价:老歌收进新出的精选集,按年代做歌单时会落进新的年代。这个字段记的不是歌曲的创作年代
保留来源专辑和年份,音轨号设为 0,不写碟号与专辑艺人。这是我管理散曲的方式,不是格式要求;想完整保留原发行信息,照写原来的轨号和专辑艺人也可以。
分类:风格、语言、来源分开写
| 字段 | 回答的问题 | 示例 |
|---|---|---|
GENRE |
它是什么风格? | Pop、City Pop、Funk |
LANGUAGE |
它用什么语言演唱? | cmn、yue、eng、jpn、zxx |
GROUPING |
它出自哪类作品? | 影视原声、游戏原声、动漫原声 |
一首日语动画主题曲,三个字段各写各的:
GENRE=Pop
LANGUAGE=jpn
GROUPING=动漫原声- 想听日语流行歌:组合
LANGUAGE和GENRE - 只想听其中的动画歌曲:再加上
GROUPING
这样就不用在 GENRE 里同时维护「日语」「日本流行」「动漫音乐」这些混了好几个维度的词。
GENRE:词表是一棵树,文件里写多个值
播放器不认识这棵树,只认文件里写着的值。只写「City Pop」,筛 Pop 时就找不到这首。
《SPARKLE》实际写着四条:
GENRE=Pop
GENRE=City Pop
GENRE=R&B
GENRE=Funk
City Pop是Pop的子标签,Funk是R&B的子标签,所以筛 Pop、City Pop、R&B、Funk 都能找到它- 有第三层时同理:
戏腔→ 写Pop、国风、戏腔Neo Soul→ 写R&B、Soul、Neo Soul
- 树只存在词表里,文件里是平铺的多个值,不写成
Pop/City Pop这样的路径5
现在的树有 11 个顶层标签、26 个子标签:6
| 顶层标签 | 子标签;› 表示再下一层 |
|---|---|
Pop |
Dance Pop、City Pop、国风 › 戏腔、网络歌曲 |
Hip-Hop |
Rap、Trap |
R&B |
Contemporary R&B、Alternative R&B、Soul › Neo Soul、Funk、Blues |
Rock |
Pop Rock、Alternative Rock、Dream Pop、Classic Rock |
Electronic |
House、Synthwave、Downtempo、Phonk |
Classical |
Baroque、Classical Period、Romantic、Contemporary Classical |
Ambient |
New Age |
Jazz、Score、Folk、Easy Listening |
暂无 |
每首歌的标签数量不设上限,但加标签有三条纪律:
- 要有风格依据:这个流派的成分撑得起一整段才加,比如主歌整段是说唱、整首是 R&B 的律动;一句念白、一段吉他 solo 这样的点缀不算
- 名称受控:只用
Dance Pop,不混写Dance-Pop,免得同义不同名的值慢慢把曲库分裂 - 来源交叉核对:
- 网易云的曲目曲风是主要来源,再用 QQ 音乐、Discogs 核对
- Last.fm 的专辑标签可以补细分风格,艺人级标签不能套到这个人的每一首歌上
- 不同来源先映射到同一棵树,冲突了再复核
LANGUAGE:记唱的语言,不从歌名猜
常用值:cmn 普通话 · yue 粤语 · eng 英语 · jpn 日语 · kor 韩语 · zxx 没有语言内容。国语和粤语分开记。7
不能拿来判断演唱语言的:
- 歌名的语言:英文标题的歌可能从头到尾唱中文
- 歌词的字形:简体歌词也可能记的是粤语
- 歌词里的中文译文、开头的制作人员署名
- 同名歌有国语、粤语两版时,要确认是哪一版录音
混合语言的歌只取一个值:
- 演唱者的母语唱段确实出现了,就取母语。日韩歌手夹着英语唱,通常仍算母语
- 没有母语唱段,按中文 → 英语 → 其他的顺序取
- 只夹一两句的不算多语种;多国合作的曲目单独处理
zxx 不等于「没找到歌词」zxx 表示已经确认没有语言内容。没有歌词,可能是数据源缺失,也可能拿错了版本。器乐、人声采样、无词吟唱要结合音频判断:人声检测能给线索,但有嗓音不等于有语言。
GROUPING:看曲子和作品的关系
只有三个值:影视原声、游戏原声、动漫原声,不记具体作品名。归不归类,看曲子和作品的关系,不看文件放在哪个目录。
| 算 | 不算 |
|---|---|
| 为作品创作的配乐、主题曲、片头片尾 | 既有歌曲后来被游戏授权使用 |
| 这些曲子的翻唱、翻奏 | 广告歌、综艺翻唱 |
| 单独收藏的电影插曲 | 为不特定影片制作的预告片音乐 |
动画电影(归 动漫原声) |
引进剧在本地播出时另配的歌曲 |
Score 和 GROUPING 的分工Score是流派,留给为作品或画面创作的器乐,也包括没有作品归属的预告片配乐- 原声带里的人声歌曲按实际风格归类,不标
Score Score可以和风格并存,旧的「Score只能单值」已经取消:
氛围取向的原创配乐:Score + Ambient
合成器取向的原创配乐:Score + Electronic + Synthwave
封面和歌词:跟着文件走
两者都嵌进文件,换位置、换播放器都不用重新抓取。但取数的粒度相反:
| 怎么取 | 检查什么 | |
|---|---|---|
| 封面 | 先确认目标专辑,取一张,嵌进整张的所有曲目 | 整张是不是同一张封面,不只是每首有没有 |
| 歌词 | 逐首匹配 | 是不是对应这首歌的这个版本 |
逐首搜封面,很容易把同一首歌在精选集、重制版里的封面混进来。
歌词的写法:
-
中文统一简体;外语保留原文,加简体中译
-
有可靠的时间轴,就内嵌双语 LRC,原文和译文共用一个时间戳:
[00:39.62]原文 [00:39.62]对应的简体中文译文 -
没有可靠的时间轴,宁可留双语纯文本,也不留一条处处错位的时间轴
-
音源和歌词可以来自不同平台,但专辑版和剪辑版差几十秒时,时间轴不能直接搬
确认是器乐后,歌词字段保留来源提供的作曲等署名,再加一行「纯音乐,请欣赏」;没有署名就只写这一行,不编造作者。有人唱却没抓到歌词的,不能拿这个标记填空。
ReplayGain:让随机播放少一点忽大忽小
入库时分析响度,把增益写进标签,由支持并开启 ReplayGain 的播放器调整音量。8
- 散曲:算曲目增益
- 整张专辑:同时算曲目增益和专辑增益
- 随机听用曲目增益
- 整张听用专辑增益,保留曲目之间原有的强弱
图中《SPARKLE》的曲目增益是 -8.03 dB,专辑增益是 -5.42 dB。这是对这份音源分析出来的结果,换个版本就不一样,不是可以照抄的参数。
前面的标签清洗可能把刚写进去的 ReplayGain 又清掉。
完成的标准:播放器读到了什么
入库顺序:
- 确认歌曲与版本
- 查重
- 决定按专辑还是散曲保存
- 核验音频
- 写身份字段、分类、封面和歌词
- 计算响度
- 上传并扫描
- 回读标签,再到播放器里检查
工具负责重复劳动,分类上的判断留给自己:
| 工具 | 负责 |
|---|---|
tagify |
写元数据、按流派词表归一化,自动补齐祖先标签 |
metaflac |
补写对应的 FLAC 字段 |
rsgain |
计算响度 |
工具链可以换,关键是整条链遵守同一套定义。写完后到播放器里查四件事:
- 身份:没认错录音;专辑名和专辑艺人整张一致;多碟顺序正确
- 分类:子标签的祖先都写上了;粤语单独分出来了;来源有实际的作品关系支撑
- 内容:整张专辑封面统一;歌词没挂错歌、没漏译、没错位;中文没有乱码
- 播放:文件能正常读取;增益字段存在;客户端能显示、能用上这些信息
Navidrome 用一部分字段识别一首歌。这些字段一改,它可能把原曲当成一首新歌,播放次数、收藏、评分和歌单归属都要跟着迁移。所以新文件尽量在入库前定好;改存量要连同历史一起规划,不能只看标签编辑器里变整齐了没有。
一套标签有没有价值,最后看它能不能让我更容易听到想听的音乐:文件夹保留稳定的位置,标签提供可以组合的入口,歌单留给几个字段概括不了的个人选择。
-
流派树服务于我的检索和混音,不是在裁定音乐史上的亲缘关系;
LANGUAGE是为了让语言歌单好用,不完整描述一首歌用到的全部语言。 ↩︎ -
「专注」太主观,我不把所有纯音乐都认定为适合专注:没有歌词的交响乐、激烈的配乐,一样可能让人分心。 ↩︎
-
MusicBrainz Picard 对 totaltracks 的定义同样以当前碟为单位。 ↩︎
-
Vorbis Comment 允许同名字段重复出现,所以能用多条
GENRE表达多值;具体播放器怎样读取,仍要实际验证。 ↩︎ -
这棵树按我的检索需求划分。比如把 Blues 收在 R&B 下是我的管理口径,别的曲库完全可以把它们并列。我最早用的是一张平铺的流派表,扩到 14 个值后,想只听 City Pop、国风或 Funk 时仍然太粗,才改成树。 ↩︎
-
我的库把藏语、蒙古语、彝语也归进
cmn这个检索桶。这是个人的合并选择:这些语言在语言学和 ISO 编码里都有自己的身份,cmn本身表示普通话。需要准确记录语种的曲库,应该分别保存实际的语言代码。 ↩︎